Observabilidad en un homelab: ver todo sin volverte loco (y qué alertas valen la pena)
Serie Homelab · Parte 2 · ← Por qué tengo un homelab · MCP: el protocolo que le da manos a la IA → · Ver la serie
TL;DR: Antes de ponerle IA a tu infraestructura, tienes que poder verla. Armé un pipeline con Alloy, Prometheus, Loki, Tempo y Grafana, y las alertas llegan al teléfono con ntfy. Y la prueba de que funciona: le pregunté a mi asistente por mis alertas y me contestó en segundos, sin que yo abriera Grafana.
¿Se puede operar algo que no puedes ver?
Se puede. Los servidores corren, los servicios responden y todo parece bien. Hasta que deja de estarlo.
El problema de operar a ciegas no es que las cosas fallen. Es que cuando fallan no sabes cuándo empezaron, ni qué cambió, ni cómo se veía el sistema cinco minutos antes. Diagnosticas en modo forense, sin evidencia. En mis primeras semanas con el homelab un servicio empezó a portarse raro y no tenía ni un registro de CPU ni un log que mirar. Es como manejar de noche sin faros: en recta funciona, en la curva no.
Y hay una razón extra para hacerlo bien si piensas ponerle un asistente de IA encima: el asistente solo sabe lo que tú le dejas ver. Si los datos son malos, te responde con mucha seguridad y muy mal. La observabilidad no es un lujo: es lo que hace útil al asistente.
El pipeline, sin PowerPoint
Nodos Proxmox / contenedores Docker / aplicaciones
        │  métricas, logs y trazas (OpenTelemetry)
        ▼
     Alloy (collector)
        ├──► Prometheus (métricas)
        ├──► Loki (logs)
        └──► Tempo (trazas)
                 │
                 ▼
          Grafana (verlo todo)  ──►  ntfy (alertas al teléfono)

          Langfuse (trazas de las llamadas a modelos de IA)
Cada flecha es una conexión real. No es un diagrama aspiracional: corre ahora mientras escribo.
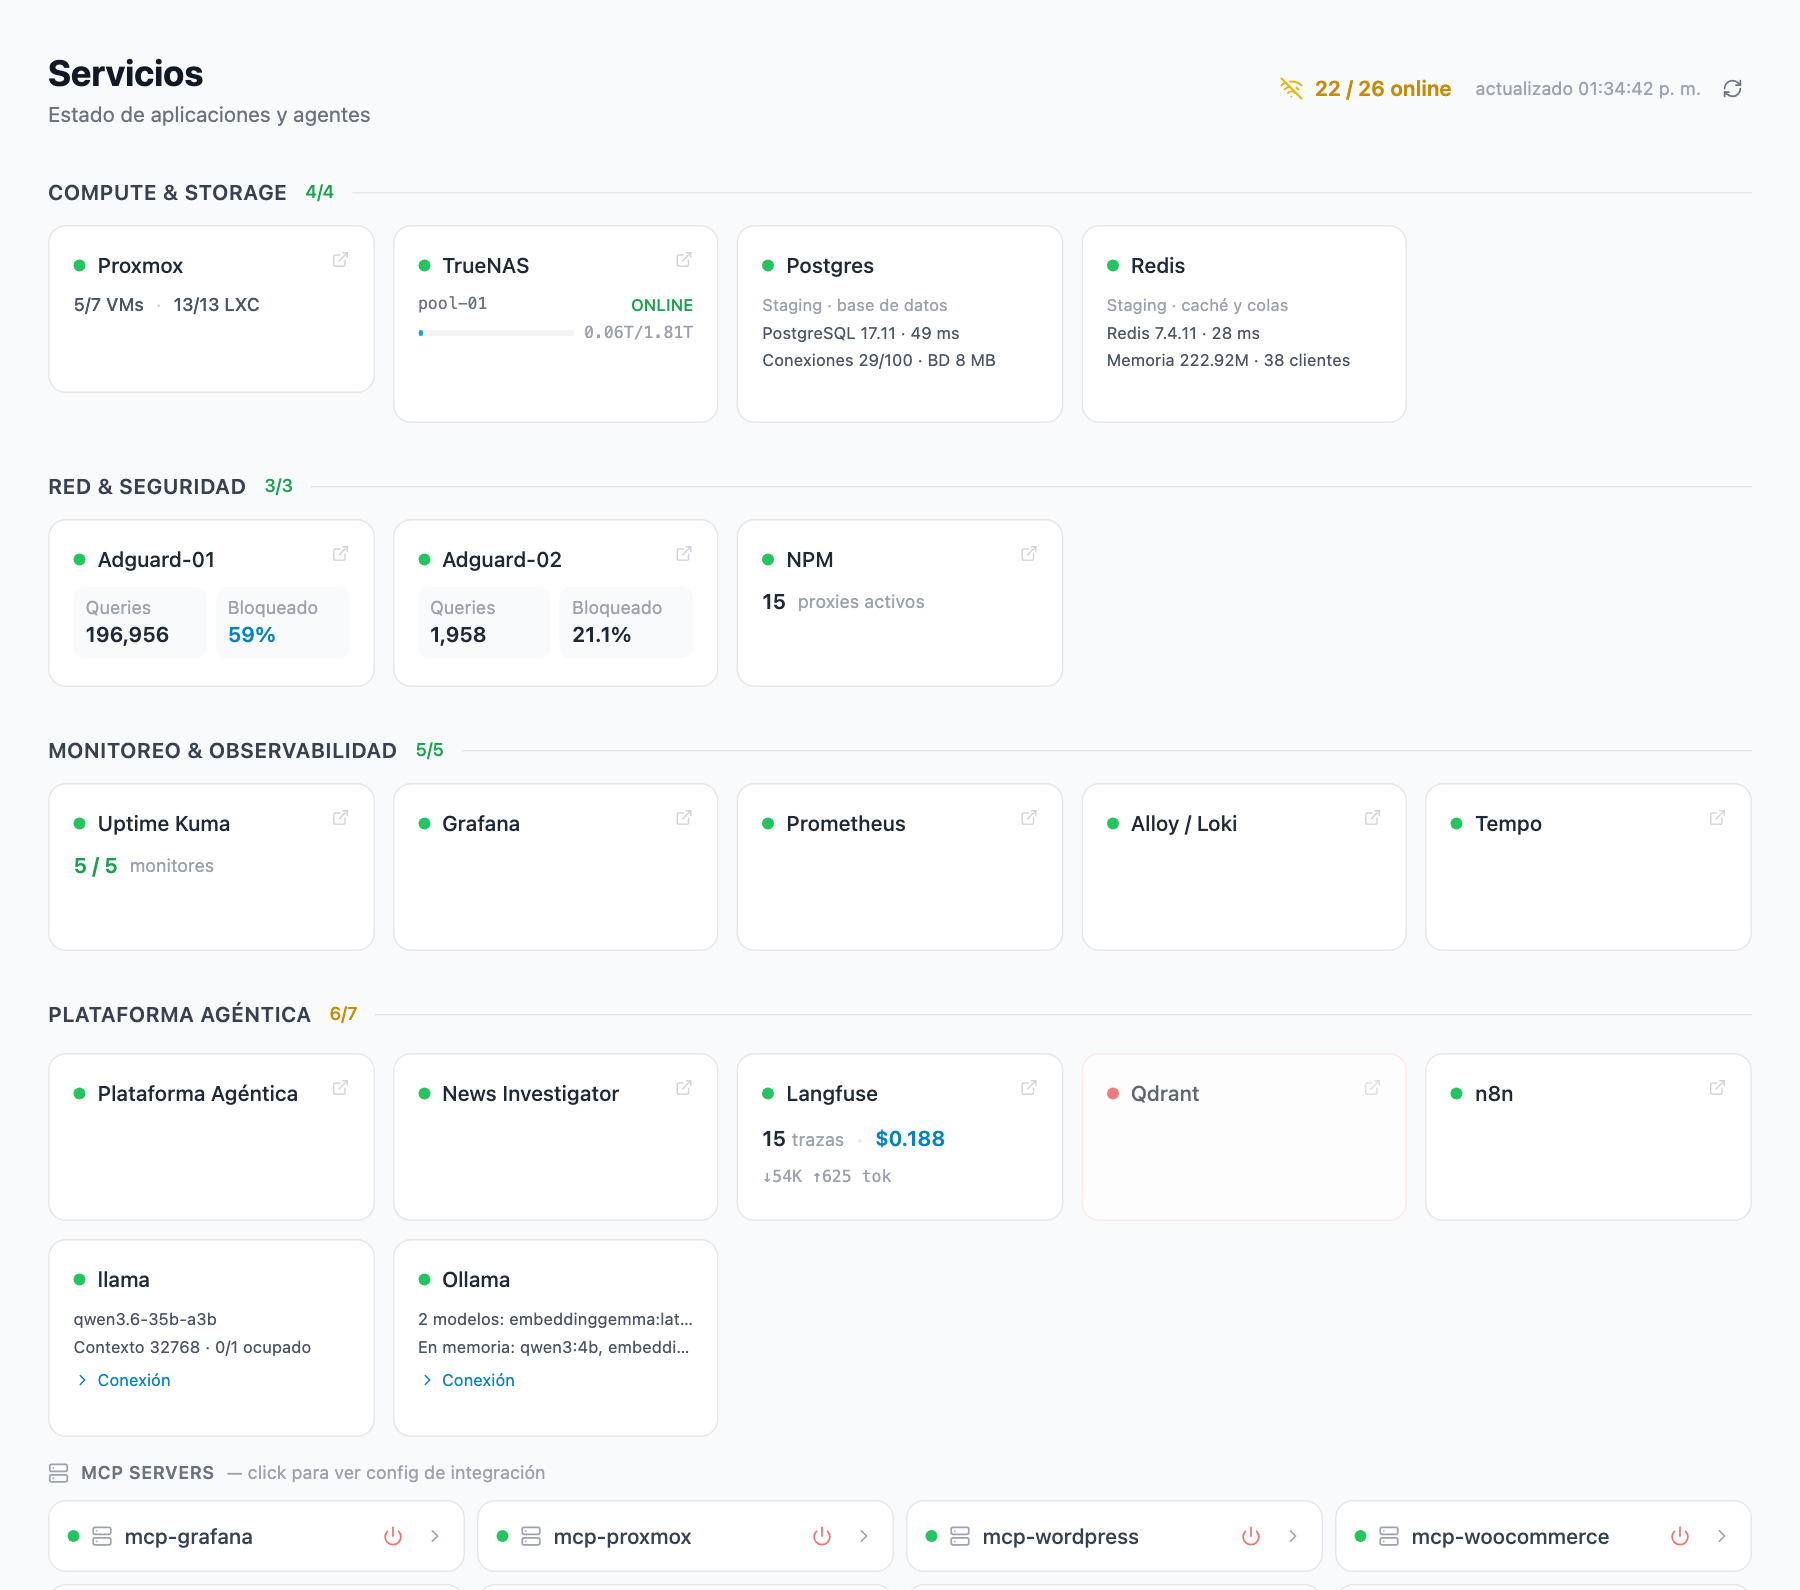
Mira cómo se ve el grupo de monitoreo en mi Dashboard:
Las piezas, rápido y sin aburrirte
OpenTelemetry. El estándar para que las aplicaciones reporten métricas, logs y trazas sin casarte con un proveedor. Instrumentas una vez y cambias el destino cuando quieras. Es más trabajo al inicio y menos dolor después.
Alloy. El collector. Viene de unir el viejo Grafana Agent con el collector de OpenTelemetry. Lo elegí sobre el collector «vanilla» porque su configuración es menos verbosa y descubre contenedores nuevos solo: levantas un contenedor y sus logs ya están llegando a Loki sin que toques nada. Eso, para alguien que levanta contenedores por deporte, es oro.
discovery.docker "containers" {
  host = "unix:///var/run/docker.sock"
}

loki.source.docker "default" {
  host       = "unix:///var/run/docker.sock"
  targets    = discovery.docker.containers.targets
  forward_to = [loki.write.local.receiver]
}

loki.write "local" {
  endpoint {
    url = "http://<loki>:3100/loki/api/v1/push"
  }
}
Prometheus. Va a buscar las métricas, no espera a que se las manden. Cada nodo tiene un Node Exporter (CPU, memoria, disco, red, temperatura) y Prometheus pasa a leerlo cada 15 segundos. Los hosts con Docker llevan cAdvisor, que mide cada contenedor. Lo mejor de Prometheus no es el tiempo real: es la historia. Con PromQL puedes preguntar «¿cómo estuvo la CPU las últimas 4 horas?» y recibir un dato, no una opinión.
Loki. Los logs, sin indexar el contenido: solo etiquetas (contenedor, imagen, host). Es mucho más barato de operar que Elasticsearch cuando no tienes un equipo dedicado a cuidarlo, y para un homelab cubre la gran mayoría de las consultas que de verdad haces.
Grafana. Donde se juntan las tres fuentes. Mis dashboards útiles son cuatro: Cluster Overview (estado de los nodos, el primero que miro), Container Metrics, Log Explorer y Agent Activity (llamadas a modelos, latencia y tokens). Y una regla que me salvó de mí mismo: si un panel no lo miro al menos una vez por semana, lo borro. Es facilísimo pasar horas armando paneles bonitos que nadie vuelve a abrir.
ntfy: alertas que llegan donde las ves
Una alerta que no ves no es una alerta, es un archivo. El correo se revisa tarde, Telegram pide un bot y Slack pide tenerlo abierto. ntfy es push self-hosted: llega al teléfono como cualquier notificación, sin bots ni apps abiertas. Grafana lo conecta con un webhook y listo.
Y sobre los umbrales hay una regla de vida: un warning demasiado bajo causa fatiga de alertas. Si suena todo el tiempo, dejas de oírlo. Por eso apagué los avisos de RAM bajos que tenía al inicio.
Le pregunto a mi asistente en vez de abrir Grafana
Mi asistente se llama ARIA (te lo cuento en otro post). Empiezo con una pregunta simple:
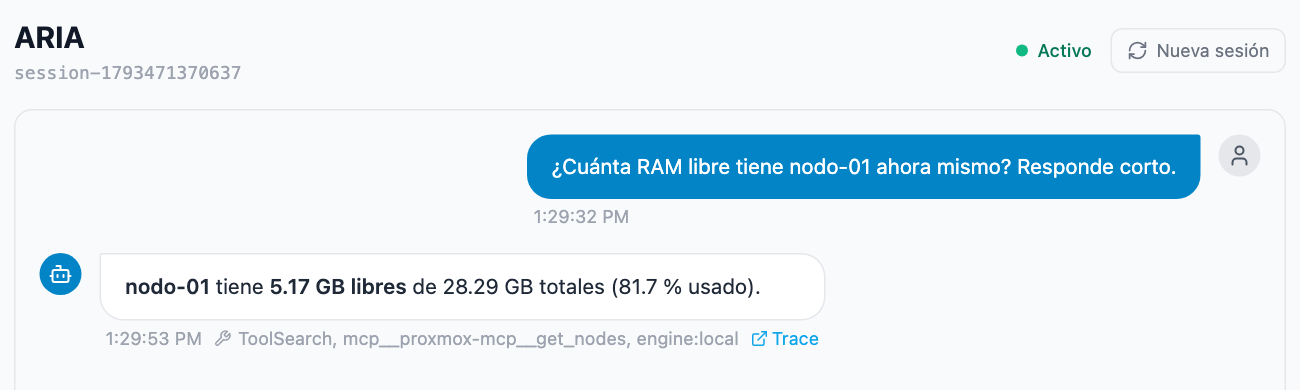
Respuesta en segundos: nodo-01 tiene 5,17 GB libres de 28,29, o sea 81,7 % de uso. Ni abrí Grafana. Esa pregunta la resolvió el modelo local, sin molestar a Claude (fíjate en la etiqueta engine:local).
Luego le pedí lo que de verdad importa:
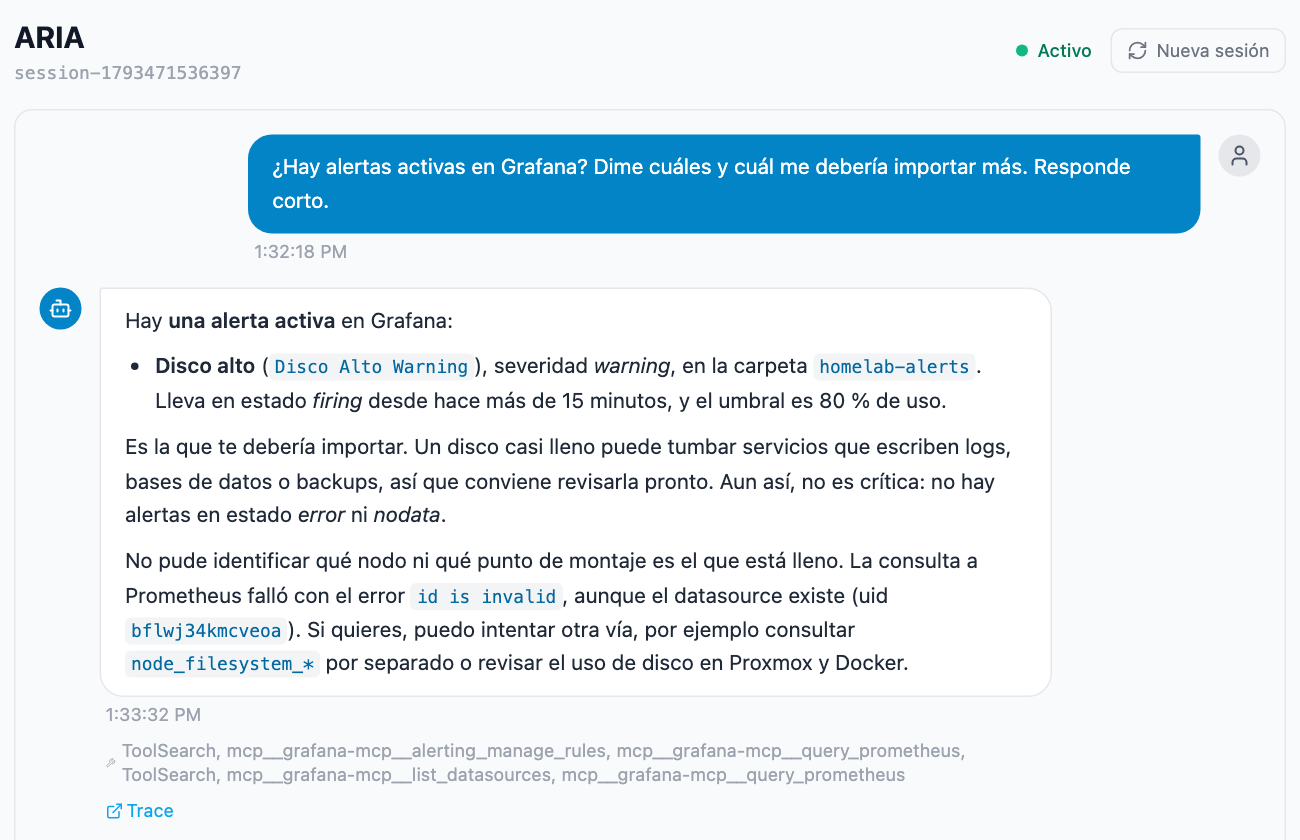
Una alerta activa: disco alto, nivel warning, umbral del 80 %. ARIA me dice que es la que debería importarme y, en el mismo mensaje, confiesa que no pudo averiguar qué disco es: su consulta a Prometheus se tropezó con un id is invalid. Mi asistente, tan seguro, y a la primera consulta se resbaló. Lo cuento porque es la vida real de operar con IA: ayuda muchísimo y no es infalible.
El Dashboard sí me dio la pista: «disco alto en dev», la VM donde vive mi VSCode.
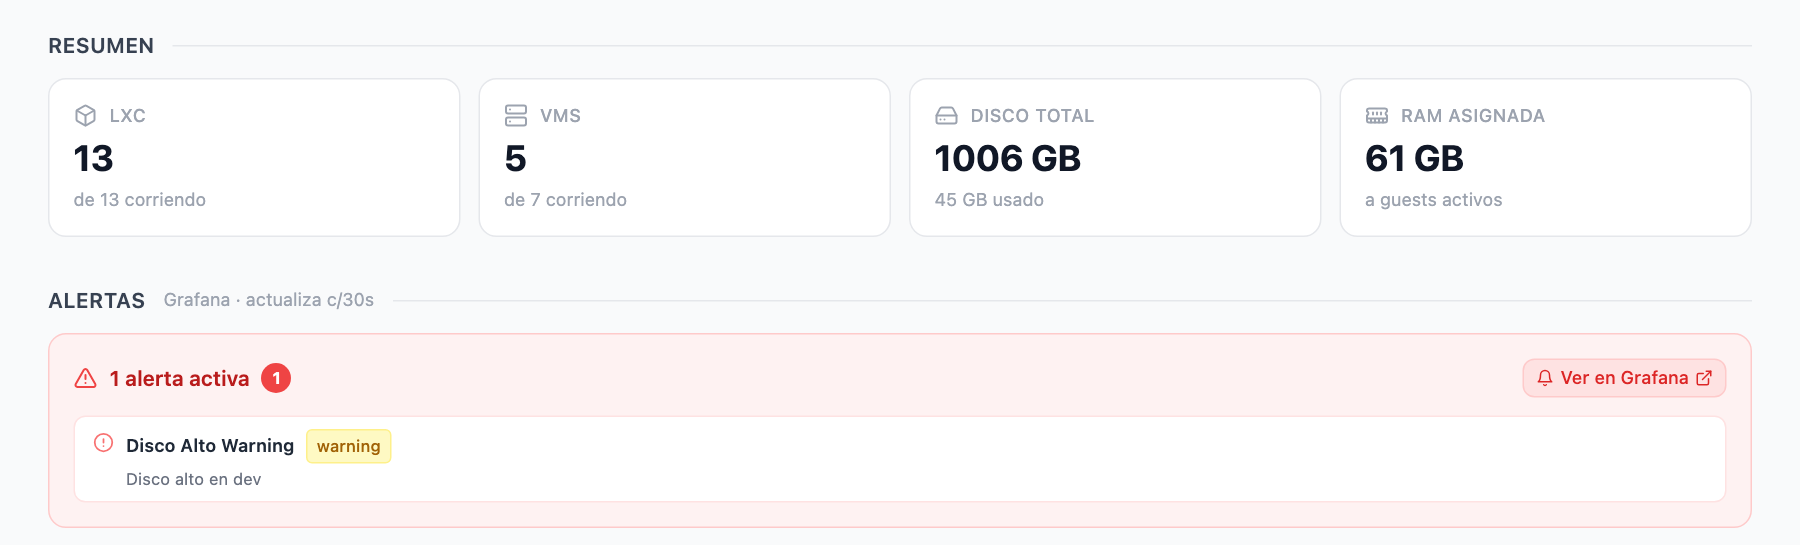
De ahí sale la moraleja de todo este post: tener alertas no es lo mismo que atenderlas. Por eso cada alerta tiene que responder una pregunta antes de existir:
- ¿Qué tendría que hacer yo cuando suene? Si la respuesta es «nada», es ruido. Fuera.
- ¿Se llena de a poco o revienta de golpe? Las de disco son las que más valen la pena: crecen despacio y nadie las ve hasta que es tarde.
- ¿Es un aviso o una urgencia? Dos niveles bastan: warning y critical.
- ¿Dice dónde duele? Un «disco alto» sin decir cuál disco te deja igual que antes de recibirlo.
Langfuse: lo que Prometheus no sabe
Prometheus sabe de infraestructura. No sabe de modelos. Cuando mi asistente responde, hace varias llamadas encadenadas: razona, usa una herramienta, razona otra vez. ¿Cuántos tokens gastó? ¿Cuánto tardó cada paso? ¿El cuello de botella fue el modelo o la herramienta?
Para eso uso Langfuse, self-hosted: guarda cada ejecución con su traza, tokens, tiempo y costo. Cada respuesta del chat trae un enlace «Trace» (míralo en las capturas de arriba). Infraestructura y modelos se observan por separado y se necesitan los dos.
Lo que me llevo
- Observabilidad primero, asistente después. En ese orden.
- Menos paneles, más uso. Si no lo miras, bórralo.
- Menos alertas, mejores alertas. Y atiéndelas, que es lo difícil.
En el siguiente post te cuento cómo mi asistente consigue «manos» para actuar sobre todo esto: el protocolo MCP, que suena a sigla de agencia secreta y es mucho más simpático.