Local primero, Claude para lo difícil: un modelo de 35B en una tarjeta de 8 GB
Serie Homelab · Parte 6 · ← Del agente ReAct a ARIA · Mi asistente me pide permiso → · Ver la serie
TL;DR: Mi asistente gasta el cerebro más pequeño que resuelva cada pregunta: primero reglas sin modelo, luego un modelo local en mi PC con una RTX 4060 y, solo si hace falta, Claude con herramientas. Sí, un modelo de 35B en una tarjeta de 8 GB. Te cuento cómo está armado, por qué, y qué no funciona tan bien.
Tres carriles
Cada pedido que llega a ARIA entra a un enrutador, y de ahí toma uno de estos caminos:
- Reglas, sin modelo. Agenda, recordatorios, enlaces, la tablet de pared, la despensa. Si se puede resolver con una regla, no despierto a ningún modelo. Es instantáneo y gratis.
- Modelo local. Las consultas simples van a un Qwen3.6 de 35B que corre en una PC dedicada. Si falla, entra Claude Haiku de respaldo.
- Claude, con herramientas. Lo complejo, lo que necesita encadenar varios pasos o usar los MCP, lo resuelve Claude Sonnet. Opus no lo uso: no lo necesito.
La regla es la del fontanero: no mandes a un especialista a cambiar un foco.
¿Un modelo de 35B en 8 GB?
Se lee mal, ya lo sé. La clave está en el nombre: 35B-A3B es un modelo de tipo mixture of experts, con 35 mil millones de parámetros en total pero solo unos 3 mil millones activos por cada token. Eso lo vuelve viable en hardware modesto, y mi PC es modesta con ganas: una RTX 4060 de 8 GB.
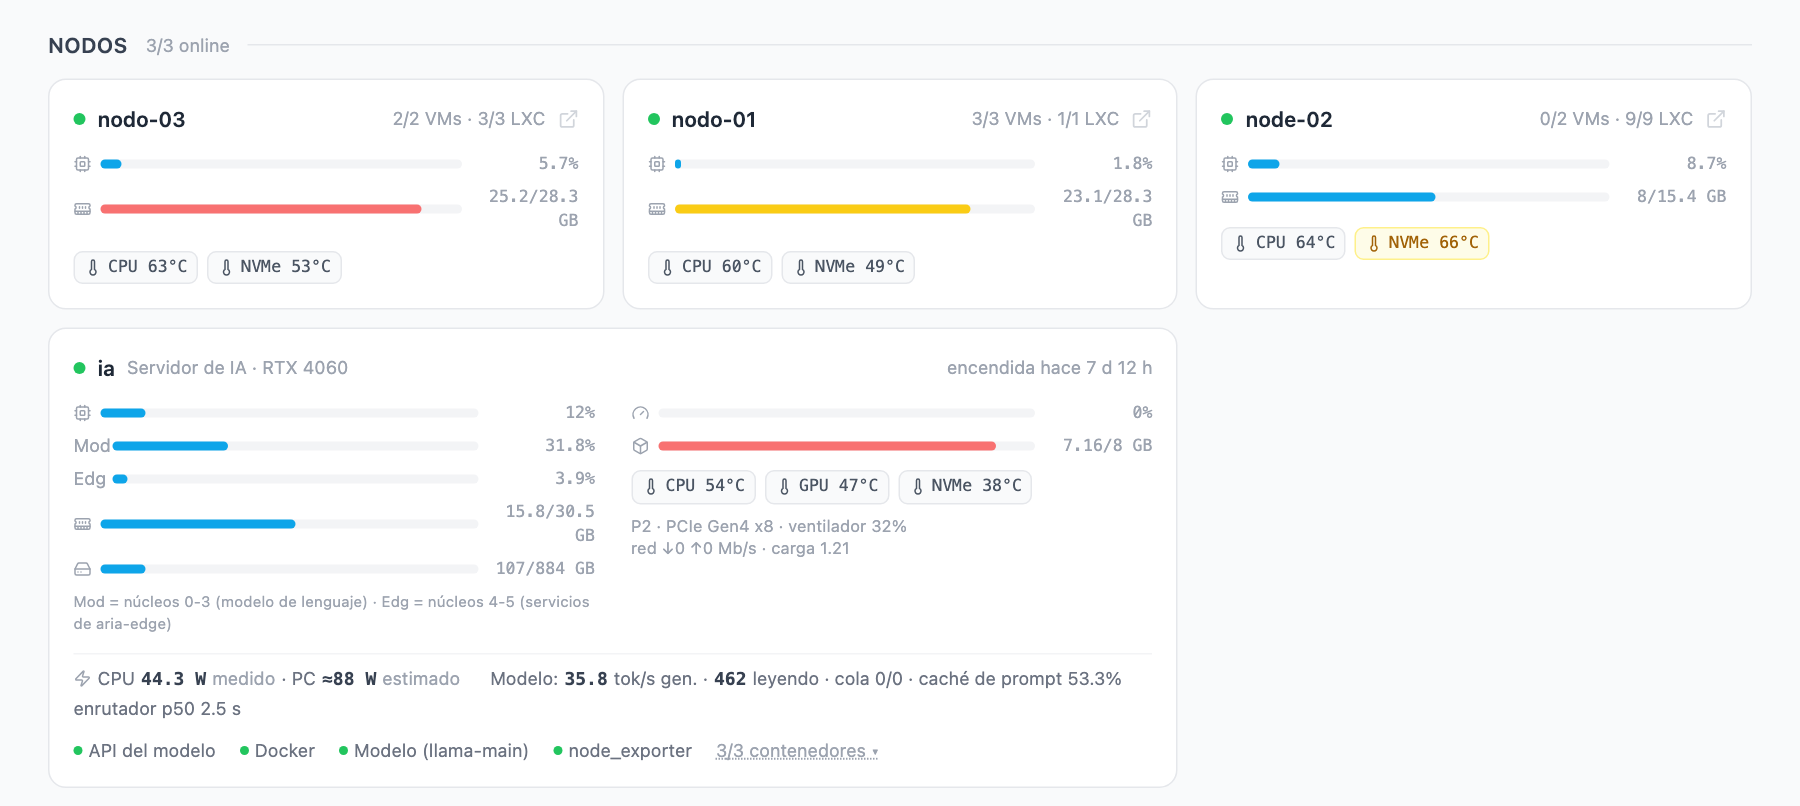
Esto es lo que dice mi propio Dashboard sobre esa PC en el momento de la captura: la VRAM está en 7,16 de 8 GB (se está esforzando, la pobre), el modelo genera unos 36 tokens por segundo y el contexto es de 32 mil tokens. En la tarjeta de la PC se ve incluso qué núcleos de la CPU están reservados para el modelo y cuáles para otros servicios.
Por qué local primero
No es una jugada de ahorro, o no solo. Hay cuatro razones:
- Control. Lo simple se resuelve sin que salga nada de mi casa.
- Costo marginal cero por pregunta simple. La GPU y la luz ya están pagadas; cada pregunta de «¿cuánta RAM tiene el nodo?» no suma a ninguna factura.
- Resiliencia. Si Claude está caído o llega a su límite, la charla simple sigue funcionando con el modelo local. Y al revés: si el local falla, entra el respaldo.
- Es un laboratorio. Me divierte probar modelos, cambiarlos, medirlos. Es mi hobby friki.
Cuánto tarda de verdad
Prefiero mostrarte números reales a venderte humo. Hoy hice dos preguntas:
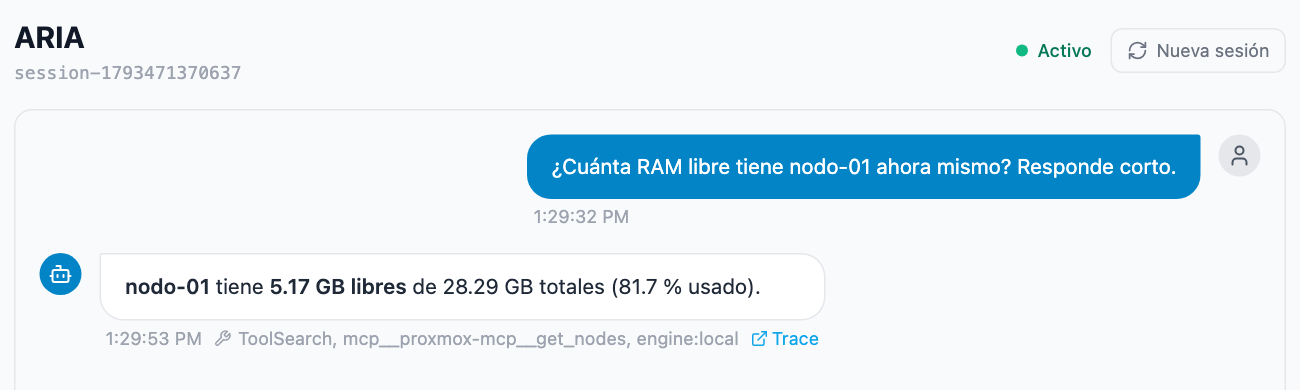
- «¿Cuánta RAM libre tiene
nodo-01?» Respondió el modelo local, y tardó unos 20 segundos de punta a punta (de 13:29:32 a 13:29:53 en la captura). - «¿Hay alertas activas en Grafana?» La resolvió Claude con herramientas, y tardó más de un minuto, con un tropiezo incluido (lo cuento aquí).
Es decir: la pregunta «simple» no fue instantánea. Local no significa rápido. Significa mío. Una nube bien alimentada le gana en velocidad a una GPU de 8 GB, y los 20 segundos incluyen buscar la herramienta, llamar al MCP de Proxmox y redactar. Lo que gano es que no dependo de nadie para esa respuesta.
Lo que no funciona tan bien
- Razona menos que Claude. Para cadenas largas de herramientas, el modelo local se enreda antes. Por eso lo difícil sube.
- El contexto es de 32 mil tokens. Sobra para charlas cortas y se queda justo con muchas herramientas a la vista (otra razón para elegir bien qué MCP conectar).
- La PC es un punto único. Si se cae, todo lo «local» se cae con ella, y ahí el respaldo en la nube se vuelve vital.
La receta, si quieres copiarla
- Reglas primero. Más de lo que crees se resuelve sin ningún modelo.
- Un modelo pequeño o mediano para lo simple. Lo importante es que sea tuyo y que lo puedas cambiar.
- Un modelo grande para lo difícil, con las herramientas conectadas.
- Respaldo en ambos sentidos, para que un carril caído no tumbe todo.
- Mide. Sin medir, «local primero» es una creencia. En la Parte 12 te muestro cómo veo cada ejecución.